
von Striped Giraffe Team
5. Oktober 2026
Lesezeit: 12 Minuten
Aufbau einer KI-fähigen Datenumgebung
Enterprise-KI lässt sich nur dann erfolgreich skalieren, wenn die zugrunde liegende Datenumgebung dauerhaft verlässlichen Kontext, konsistente Semantik, kontrolliertes Wissen und betriebliche Stabilität bereitstellt – über alle Modelle, Workflows und Entscheidungsebenen hinweg.
Eine KI-fähige Datenumgebung ist eine Datenarchitektur und Betriebsorganisation, die KI-Systeme kontinuierlich mit hochwertigen, nachvollziehbaren und zugriffsgeschützten Daten versorgt. Sie verbindet Datenqualität, Data Governance, Semantik, AI-Serving und Observability zu einer belastbaren Grundlage für den produktiven KI-Einsatz.
Teil 1 hat gezeigt, warum Unternehmensdaten häufig nicht mehr ausreichen, sobald KI den Sprung vom Pilotprojekt in den produktiven Betrieb vollzieht: fragmentierte Definitionen, verborgene Qualitätsprobleme, unzureichend verwaltete Inhalte, aufwendige Datenzugriffe und unklare Verantwortlichkeiten.
Dieser zweite Teil überführt diese Schwachstellen in ein konkretes Zielmodell. Er beschreibt fünf Module, mit denen Unternehmen ihren KI-Systemen verlässlichen Kontext, kontrolliertes Wissen und produktionsreife Datenflüsse im erforderlichen Umfang bereitstellen können.
Die fünf Module sind eng miteinander verbunden und bilden keine starre Abfolge. Nach der ersten Analyse der KI-Nutzungsmuster werden AI-Serving-Funktionen, Semantik, Governance und Observability in der Regel parallel weiterentwickelt. Priorität haben dabei die Kontrollen und Fähigkeiten, die für die wertvollsten KI-Anwendungsfälle benötigt werden.
- Modul 1: KI-Nutzungsmuster definieren, bevor die Architektur entsteht
- Modul 2: Governance-konforme Datenprodukte und AI-Serving-Funktionen etablieren
- Modul 3: Gemeinsame Semantik und Ownership operationalisieren
- Modul 4: Unstrukturiertes Wissen als produktive Ressource steuern
- Modul 5: Kontinuierliche Datenqualität und KI-Observability etablieren
Modul 1:
KI-Nutzungsmuster definieren, bevor die Architektur entsteht
Unternehmensweite Datenumgebungen unterstützen selten nur einen einzelnen KI-Workload.
Retrieval-basierte Copiloten, Prognosemodelle, Empfehlungssysteme, operative Assistenten und agentische Workflows greifen auf unterschiedliche Weise auf Daten zu. Ein System für Empfehlungen mit geringer Latenz stellt daher andere Anforderungen als ein Wissensassistent, der autoritative Dokumente unter Berücksichtigung der jeweiligen Quellsystemberechtigungen abrufen muss.
Bevor Plattformen ausgewählt oder Datenpipelines entworfen werden, sollte jeder geplante KI-Workload anhand von sechs Fragen analysiert werden:
- Welche Quellen und Datenprodukte sind maßgeblich und vertrauenswürdig?
- Welche Entitäten, Definitionen und historischen Zusammenhänge müssen konsistent bleiben?
- Welche Anforderungen bestehen an Datenqualität, Aktualität, Latenz und Verfügbarkeit?
- Welche Daten sind sensibel und welche Berechtigungen aus den Quellsystemen müssen erhalten bleiben?
- Welche Lineage, Nachweise und Audit-Trails müssen für Ergebnisse oder ausgeführte Aktionen verfügbar sein?
- Welche regulatorischen Vorgaben, Aufbewahrungsfristen und internen Richtlinien gelten?
An dieser Analyse sollten folgende Bereiche beteiligt sein:
- Datenarchitektur
- AI Engineering
- Data Governance
- Informationssicherheit
- verantwortliche Fachbereiche und Datendomänen
Das zentrale Ergebnis ist ein KI-Nutzungsinventar (AI Consumption Inventory). Es verknüpft jeden priorisierten Workload mit seinen Quellen, der jeweiligen Nutzungsart, semantischen Abhängigkeiten, Service Levels, Kontrollen und verantwortlichen Eigentümern.
Dieses Inventar führt nicht zu einer separaten Architektur für jedes KI-System. Es zeigt vielmehr, welche Fähigkeiten gemeinsam genutzt werden können und an welchen Stellen domänenspezifische Lösungen erforderlich bleiben.
Modul 2:
Governance-konforme Datenprodukte und AI-Serving-Funktionen etablieren
Viele Unternehmensdatenplattformen wurden ursprünglich für Reporting, Dashboards und historische Analysen entwickelt. KI-Systeme stellen zusätzliche betriebliche Anforderungen, die häufig eine eigene KI-Bereitstellungsschicht (AI-Serving Layer) zwischen Datenquellen, Datenplattform und KI-Anwendungen erforderlich machen.
Diese Schicht übernimmt typischerweise:
- semantische Modellierung
- semantische Anreicherung
- Optimierung des Informationsabrufs
- konsistente Bereitstellung von Features
- Zusammenstellung des benötigten Kontexts
- Standardisierung von Metadaten
- Vektorindizierung
- kontrollierte Zugriffsmuster für KI-Systeme
Eine solche KI-Bereitstellungsschicht muss nicht zwangsläufig als physisch getrennte Plattform umgesetzt werden. Sie kann auch aus logisch zusammengehörenden Funktionen innerhalb eines bestehenden Lakehouse, Data Mesh, einer Integrationsplattform oder Wissensarchitektur bestehen. Entscheidend ist, wiederverwendbare Bereitstellungslogik von einzelnen KI-Anwendungen zu trennen. So müssen Teams Datenpipelines, Berechtigungen und Transformationen nicht für jeden Anwendungsfall neu aufbauen.
Governance-konforme Datenprodukte bilden die Grundlage dieser Schicht. Jedes Datenprodukt benötigt
- einen verantwortlichen Eigentümer,
- einen klar definierten Zweck,
- dokumentierte Semantik,
- eine stabile Nutzungsschnittstelle,
- Ziele für Qualität und Aktualität,
- nachvollziehbare Lineage
- sowie durchsetzbare Zugriffsregeln.
Diese Vereinbarungen erleichtern das Auffinden und Verwenden von Daten und reduzieren manuelle Exporte, langwierige Freigabeprozesse, lokale Kopien und Schattenpipelines.
Kuratierte Wissensbestände für Retrieval und RAG
Enterprise-Copiloten und Systeme auf Basis von Retrieval-Augmented Generation (RAG) sollten auf kuratierte Wissensbestände zugreifen, statt vollständige Repositories ungefiltert verfügbar zu machen. Eine solche Sammlung muss maßgebliche Inhalte kennzeichnen, die Lineage von Dokumenten und abgeleiteten Artefakten bewahren, Zugriffsklassen übernehmen sowie Prüf- und Aktualisierungsregeln definieren.
Auch Chunking und Anreicherung sollten auf die jeweilige Domäne abgestimmt sein. Verträge, technische Spezifikationen, Serviceanweisungen und Produktinformationen benötigen in der Regel unterschiedliche Segmentierungslogiken.
Pipelines zur Metadatenanreicherung
Metadaten sind eine produktive Abhängigkeit von Enterprise-KI-Systemen. Unternehmen benötigen daher Anreicherungspipelines, die strukturierte und unstrukturierte Datenbestände automatisiert um folgende Informationen ergänzen:
- Ownership
- Geschäftstaxonomie
- Vertraulichkeits- und Sensitivitätskennzeichnungen
- Lineage-Referenzen
- Aufbewahrungsregeln
- Hinweise auf die Autorität und Verlässlichkeit der Quelle
- semantische Schlagwörter und Klassifizierungen
Automatisierte Klassifizierung beschleunigt diese Arbeit. Besonders kritische Attribute müssen jedoch weiterhin validiert werden und einer klaren Verantwortung unterliegen.
Feature-Serving-Umgebungen
Prädiktive KI-Systeme benötigen häufig Feature-Serving-Layers, die konsistente Merkmale für Modelltraining, Validierung, Experimente und produktive Inferenz bereitstellen. Hier gewinnen Feature Stores betriebliche Bedeutung.
Unternehmen wie Uber und Airbnb haben öffentlich dokumentiert, wie ein zentralisiertes Feature Management die Konsistenz zwischen Trainings- und Produktionsumgebungen verbessert. Solche Architekturen reduzieren insbesondere:
- Training-Serving-Skew
- doppelt implementierte Transformationslogik
- inkonsistente Trainingsdatensätze
- betriebliche Instabilität
Feature Drift und Concept Drift werden dadurch nicht automatisch verhindert. Sie müssen im laufenden Betrieb gesondert überwacht werden.
Modul 3:
Gemeinsame Semantik und Ownership operationalisieren
KI-Systeme sind fortlaufend auf eine konsistente geschäftliche Bedeutung der verarbeiteten Daten angewiesen.
Mit zunehmender KI-Nutzung wirken sich widersprüchliche Begriffe und Definitionen unmittelbar aus auf:
- Retrieval-Pipelines
- Empfehlungen
- Prognoselogik
- agentische Workflows
- generierte Antworten
Ohne stabile semantische Kontrollen entstehen konkrete Risiken:
- Retrieval-Systeme stellen widersprüchlichen Kontext zusammen.
- Prognosemodelle verarbeiten inkonsistente historische Daten.
- Empfehlungssysteme übernehmen fragmentierte Verhaltenssignale.
- Autonome Workflows handeln möglicherweise auf Grundlage eines unvollständigen betrieblichen Verständnisses.
Unternehmen benötigen deshalb Mechanismen zur semantischen Stabilisierung, unter anderem:
- kanonische Geschäftsdefinitionen
- kontrollierte KPI-Logik
- unternehmensweite Business-Glossare
- Verfahren zur Entitätsauflösung
- semantische Lineage
- domänenübergreifende Governance-Prozesse
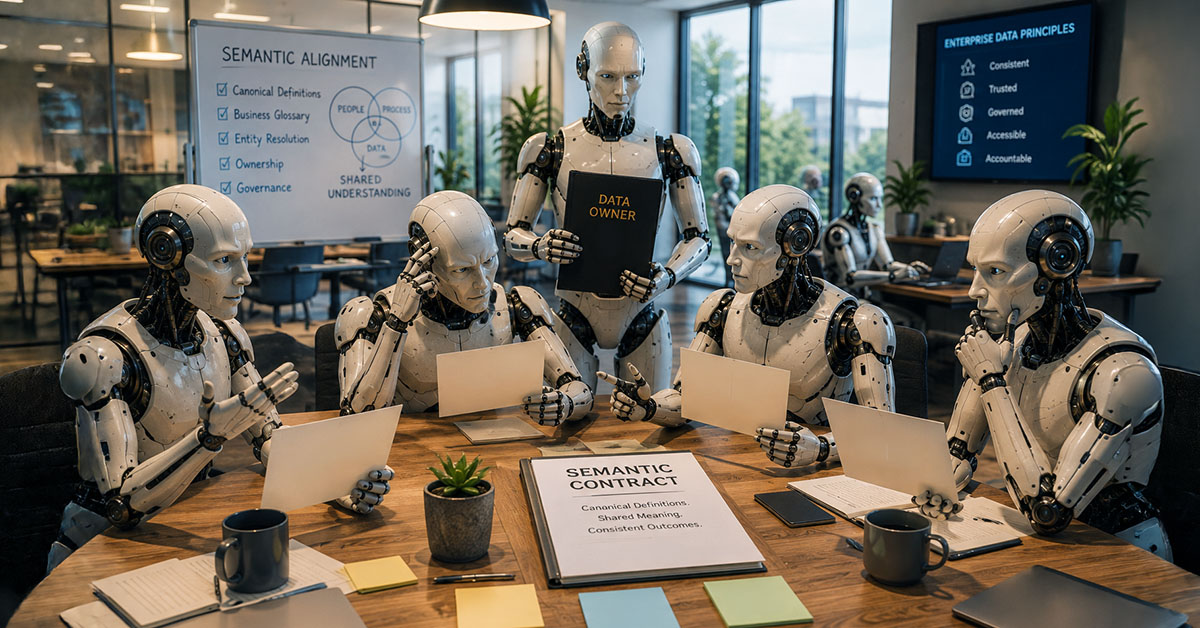
Diese Kontrollen sollten nicht ausschließlich in Dokumentationen hinterlegt sein, sondern über wiederverwendbare semantische Verträge und Schnittstellen wirksam werden.
Ebenso wichtig ist die eindeutige Ownership. Ein Governance-Gremium kann domänenübergreifende Konflikte lösen, ersetzt aber keine operative Verantwortung. Jedes kritische Datenprodukt, jeder Retrieval-Bestand und jede semantische Definition benötigt einen benannten Eigentümer. Dieser verantwortet Qualität, Aktualität, Zugriffe, Lebenszyklusentscheidungen und Fehlerbehebung.
Plattformteams stellen gemeinsame Services bereit. Die Verantwortung für Bedeutung und Eignung der Daten für den jeweiligen Verwendungszweck verbleibt jedoch bei den zuständigen Datendomänen.
Modul 4:
Unstrukturiertes Wissen als produktive Ressource steuern
Wie Teil 1 gezeigt hat, enthalten unstrukturierte Repositories häufig genau den Kontext, den KI-Systeme besonders dringend benötigen. Gleichzeitig finden sich dort doppelte, veraltete, wenig verlässliche oder unzureichend klassifizierte Inhalte.
Die Lösung besteht nicht darin, einfach weitere Dokumente in Embeddings zu überführen. Erforderlich ist ein verbindliches Modell für autoritatives Unternehmenswissen.
Dieses Modell sollte festlegen:
- welche Quellen und Versionen innerhalb einer Domäne maßgeblich sind
- wer Inhalte prüft, freigibt, archiviert und außer Kraft setzt
- wie Autorität, Aktualität, Sensitivität und Aufbewahrungsfristen in Metadaten abgebildet werden
- wie redundante, veraltete und triviale Inhalte – sogenannter ROT Content – identifiziert und entfernt werden
- wie das Retrieval-Verhalten validiert wird, bevor Wissensbestände für KI-Systeme freigegeben werden
Berechtigungen müssen erhalten bleiben, wenn Dokumente in Texte, Tabellen, Bilder, Chunks, Embeddings und Indizes zerlegt werden. Zugriffsrechte aus den Quellsystemen, Datenschutzklassifizierungen und das Prinzip der geringsten Rechte müssen deshalb über den gesamten Ingestion- und Retrieval-Prozess hinweg durchgesetzt werden.
Abgeleitete Artefakte müssen bis zu ihrer ursprünglichen Quelle zurückverfolgt werden können. Nur so lassen sich Ergebnisse zuverlässig untersuchen, korrigieren und erneut verarbeiten.
Modul 5:
Kontinuierliche Datenqualität und KI-Observability etablieren
Datenqualität für KI ist anwendungsfallspezifisch. Daten müssen nicht in jeder Dimension perfekt sein. Sie müssen jedoch für die jeweilige Entscheidung, Antwort oder Aktion geeignet sein. Qualitätsziele sollten deshalb diejenigen Dimensionen abdecken, die für den jeweiligen Workload relevant sind – etwa Vollständigkeit, Richtigkeit, Aktualität, Repräsentativität, semantische Konsistenz, historische Korrektheit und Label-Qualität.
Diese Ziele müssen in betriebliche Service-Levels übersetzt werden. Abhängig vom Workload definieren sie beispielsweise die maximal zulässige Synchronisationslatenz, Aktualisierungsfrequenz, Verfügbarkeit, erlaubtes Datenalter und Ablaufregeln für zeitkritischen Kontext.
KI-Observability verbindet diese Kontrollen auf Daten- und Quellenebene mit dem tatsächlichen Verhalten des KI-Systems. Das Monitoring sollte dabei zwischen verschiedenen Arten von Workloads und Kontrollen unterscheiden:
- RAG und Copiloten: Retrieval Precision und Recall, Qualität des Rankings, Quellenverankerung beziehungsweise Groundedness, Korrektheit von Quellenangaben, Autorität und Aktualität der Quellen, Durchsetzung von Zugriffsrechten, Latenz und Kosten
- Prädiktive KI: Validierungsfehler, Verfügbarkeit von Features, Training-Serving-Skew, Feature Drift, Distribution Drift, Concept Drift, Integrität historischer Signale und Modellleistung
- Agentische Workflows: Genauigkeit der Werkzeugauswahl, Durchsetzung von Richtlinien, Ergebnisse ausgeführter Aktionen, Ausnahmefälle und vollständige Audit-Trails
- Übergreifende Daten- und Wissenskontrollen: semantische Drift, unterbrochene Lineage, Verletzungen von Aktualitäts-SLAs, Veränderungen der Quellenautorität und unerwartete Veränderungen im Retrieval- oder Ausgabeverhalten
Retrieval-Systeme sollten außerdem Regressionstests durchlaufen, sobald sich Repositories, Metadaten, Chunking-Strategien, Embedding-Modelle oder Indizes verändern. Dadurch lässt sich überprüfen, ob relevante Informationen auch bei einer sich wandelnden Wissensbasis weiterhin konsistent auffindbar bleiben.
Nicht jede fehlerhafte Antwort sollte pauschal als Halluzination des Modells eingestuft werden. Teams sollten nicht belegte oder widersprüchliche Ausgaben über den abgerufenen Kontext, die Lineage der Quellen, semantische Definitionen, Berechtigungen und den Pipeline-Status bis zu ihrer Ursache zurückverfolgen.
Wiederkehrende Fehlermuster und die Stabilität der Ausgaben sollten anhand kontrollierter Testbestände bewertet werden – ohne von nicht deterministischen Modellen identische Antworten zu erwarten.
Das Ziel ist nicht nur die Erkennung, sondern die Behebung der Ursache: Quellen oder Metadaten korrigieren, betroffene Artefakte oder Features neu erzeugen, bei Bedarf erneut indexieren oder trainieren und das Ergebnis anschließend mit denselben Tests validieren.
Dieser Feedback-Loop erfordert definierte Service-Levels, klare Verantwortlichkeiten für Störfälle, Eskalationswege und regelmäßige Überprüfungen. Observability wird damit zu einer dauerhaften betrieblichen Disziplin – und nicht zu einem Dashboard, das erst nach der Einführung ergänzt wird.
Sicherheit, Datenschutz und Compliance wirken über alle fünf Module hinweg
Sicherheit und Compliance dürfen nicht als abschließende Freigabestufe behandelt werden. Datenklassifizierung, durchgängige Identitäts- und Berechtigungsweitergabe, Policy Enforcement, Aufbewahrungsregeln, Auditierbarkeit und regulatorische Anforderungen müssen von Beginn an im KI-Nutzungsinventar, in Datenprodukten, Retrieval-Beständen, semantischen Kontrollen und im Monitoring-Modell verankert werden.
Dies ist besonders wichtig, wenn KI-Systeme nicht nur Empfehlungen erzeugen, sondern selbstständig geschäftliche Aktionen auslösen können.
Fazit
Unternehmensdaten für KI vorzubereiten bedeutet weit mehr, als Repositories zusammenzuführen oder eine neue Plattform einzuführen. Erforderlich ist eine Betriebsumgebung, in der Daten und Wissen über kontrollierte Datenprodukte, explizite Semantik, geregelte Zugriffe, verlässliche Bereitstellungsmuster und messbare Service Levels verfügbar gemacht werden.
Der praktische Ausgangspunkt ist ein KI-Nutzungsinventar für eine begrenzte Zahl besonders wertvoller Workloads. Darauf aufbauend können Unternehmen erkennen, welche gemeinsamen Fähigkeiten bereits vorhanden sind, wo Verantwortlichkeiten und Qualitätskontrollen fehlen und welche Investitionen Risiken reduzieren oder mehrere KI-Anwendungsfälle gleichzeitig beschleunigen.
Unternehmen, die diese Fähigkeiten als wiederverwendbare Enterprise-Infrastruktur aufbauen, können isolierte KI-Pilotprojekte zuverlässiger in kontrollierte, produktive Systeme überführen.
Ein nachhaltiger Wettbewerbsvorteil durch Enterprise-KI entsteht daher zunehmend dort, wo Unternehmen vertrauenswürdige Datenumgebungen operationalisieren können – Datenumgebungen, die im produktiven Maßstab dauerhaft verlässlichen Kontext, kontrolliertes Wissen und stabile Semantik bereitstellen.
Das könnte Ihnen auch gefallen:
- AI Data Readiness, Teil 1: Warum Unternehmensdaten für KI oft nicht bereit sind » Mehr erfahren
- KI im E-Commerce (E-Book) » Mehr erfahren
- Was Googles Universal Commerce Protocol für die Zukunft des B2B-Commerce bedeutet » Mehr erfahren
- Agentic Commerce: Strategische Prioritäten für Führungskräfte » Mehr erfahren
- Agentic Commerce: Das neue Machtgefüge im digitalen Handel » Mehr erfahren
- Agentic Commerce: So werden Gespräche zu Käufen » Mehr erfahren
- Generative KI erschließt das Potenzial unstrukturierter Daten in der Versicherungswirtschaft » Mehr erfahren