
von Striped Giraffe Team
28. September 2026
Lesezeit: 9 Minuten
Warum Unternehmensdaten für KI oft nicht bereit sind
KI-Projekte scheitern selten in der Demo. Die meisten Herausforderungen treten erst dann auf, wenn Modelle mit der Realität gewachsener Unternehmenslandschaften konfrontiert werden – mit Datenumgebungen, die nie dafür entwickelt wurden, KI-Systeme im großen Maßstab zu unterstützen.
Auf den ersten Blick scheinen viele Unternehmen gut vorbereitet. Sie verfügen über moderne Datenplattformen, Cloud-Infrastrukturen, Integrationsschichten, Governance-Programme und jahrelang gesammelte Datenbestände. Entsprechend werden diese Umgebungen häufig als „AI-ready“ eingestuft.
Sobald KI-Systeme jedoch beginnen, direkt auf Unternehmensdaten zuzugreifen, treten immer wieder dieselben Probleme auf:
- inkonsistente Ergebnisse
- unzuverlässige Antworten
- widersprüchliche Informationen
- mangelndes Vertrauen in KI-generierte Inhalte
- hoher manueller Prüfaufwand
- steigende operative Komplexität rund um eigentlich automatisierte Prozesse
Die Ursache liegt dabei selten im Modell selbst.
Sie liegt in der Qualität, Struktur, Verfügbarkeit und Steuerbarkeit der zugrunde liegenden Daten.
Klassische Analyse- und Reportingumgebungen konnten viele dieser Schwächen lange kompensieren. Analysten korrigierten Inkonsistenzen manuell. Fachbereiche interpretierten mehrdeutige Felder anhand ihres Erfahrungswissens. Fehler wurden durch lokale Anpassungen in Berichten oder Prozessen ausgeglichen.
KI-Systeme funktionieren anders.
Large Language Models, Copilots, Empfehlungssysteme, Forecasting-Modelle oder Retrieval-Pipelines verarbeiten Daten direkt, kontinuierlich und in großem Umfang. Unter diesen Bedingungen werden Probleme sichtbar, die zuvor verborgen blieben.
Viele Unternehmen stellen deshalb fest:
Große Datenmengen bedeuten nicht automatisch, dass die Daten auch für KI nutzbar sind.
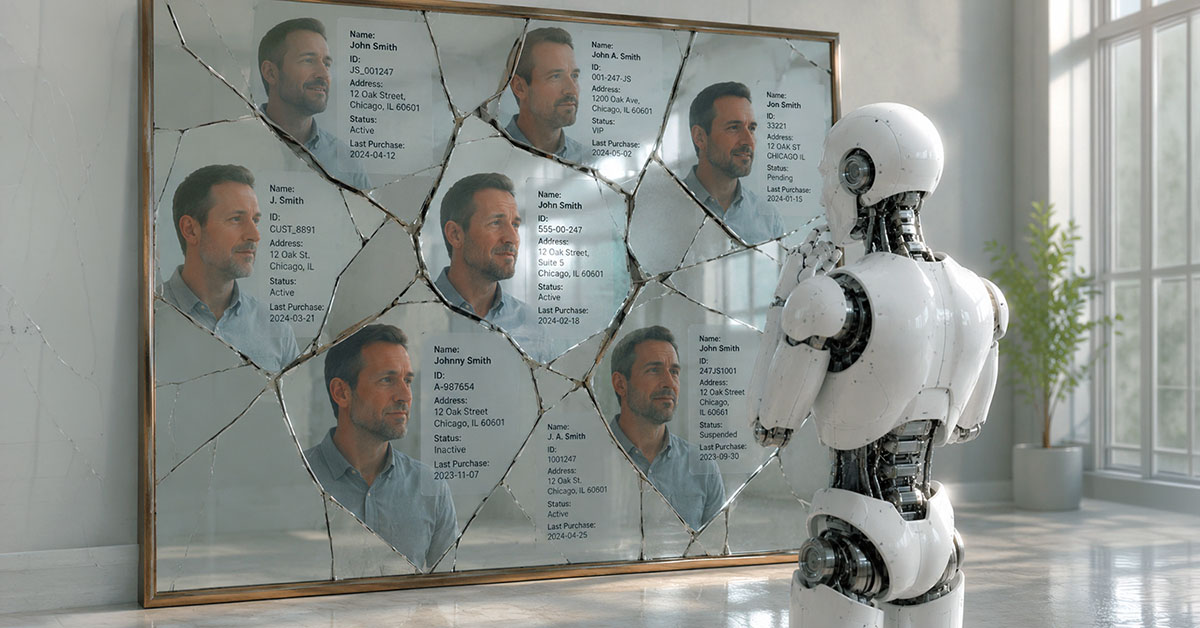
Fragmentierte Daten erzeugen fragmentierte KI-Ergebnisse
Die meisten Unternehmen verfügen bereits über die Daten, die sie für KI-Initiativen benötigen.
Die eigentliche Herausforderung besteht darin, daraus ein konsistentes und verlässliches Abbild der Realität zu schaffen.
Besonders deutlich wird das am Beispiel von Kundendaten.
Informationen zu Kundenidentitäten, Transaktionen, Supportfällen, Produktnutzung oder Marketinginteraktionen verteilen sich häufig auf:
- CRM-Systeme
- ERP-Landschaften
- E-Commerce-Plattformen
- Service- und Supportsysteme
- Marketing-Automation-Lösungen
- externe Partneranwendungen
Technisch betrachtet sind diese Systeme oft miteinander verbunden.
Inhaltlich arbeiten sie jedoch häufig mit:
- unterschiedlichen Identifikatoren
- unterschiedlichen Aktualisierungszyklen
- unterschiedlichen Definitionen
- unterschiedlichen Interpretationen dessen, was einen Kunden, eine Transaktion oder eine Interaktion ausmacht
In klassischen Reporting-Prozessen lassen sich solche Unterschiede häufig manuell ausgleichen.
Für KI-Systeme werden sie jedoch zum Problem.
Widersprüche fließen direkt in Trainingsdaten, Empfehlungssysteme, Retrieval-Prozesse und Entscheidungslogiken ein.
Die Folgen zeigen sich in vielen KI-Anwendungen:
- Empfehlungssysteme basieren auf widersprüchlichen Kundenprofilen
- Copilots kombinieren veraltete Produktinformationen mit aktuellen Preisen
- Forecasting-Modelle arbeiten mit unterschiedlichen Kennzahlen aus verschiedenen Unternehmensbereichen
So entsteht die Illusion von AI Readiness:
Die Daten sind vorhanden.
Die Integrationen existieren.
Die Plattformen laufen.
Und dennoch fehlt ein konsistentes, belastbares Abbild der Realität, das KI-Systeme zuverlässig nutzen können.
Datenqualitätsprobleme werden erst sichtbar, wenn KI sie nutzt
Viele Unternehmen halten ihre Datenqualität für ausreichend.
Dashboards funktionieren. Kennzahlen wirken plausibel. Geschäftsentscheidungen werden weiterhin auf Basis vorhandener Reports getroffen.
Was dabei häufig unsichtbar bleibt, ist der erhebliche manuelle Aufwand hinter den Kulissen.
In der Praxis werden:
- Datensätze korrigiert
- fehlende Werte ergänzt
- Inkonsistenzen lokal behoben
- problematische Felder bewusst umgangen
Menschen gleichen Schwächen aus, die im System selbst nie behoben wurden.
Genau diese Korrekturschicht entfällt jedoch bei KI-Systemen.
Wenn Modelle direkt auf Unternehmensdaten zugreifen:
- gelangen fehlerhafte Labels in Trainingsdaten
- verzerren Dubletten Empfehlungen
- beeinflussen veraltete Informationen die Ergebnisse
- verschlechtert fehlender Kontext die Qualität von Retrieval-Prozessen
Viele Unternehmen erkennen diese Probleme erst nach der Einführung von:
- RAG-Systemen
- Dokumentenintelligenz-Lösungen
- Enterprise Copilots
- Empfehlungssystemen
- Predictive-Analytics-Plattformen
Dann wird deutlich, dass die bisher als „ausreichend“ betrachtete Datenqualität stark von menschlicher Interpretation und Korrektur abhängig war.
KI macht diese Schwächen sichtbar.
Unternehmensdaten wurden nie für KI entwickelt
Die meisten Unternehmensdatenlandschaften wurden ursprünglich für Transaktionen, Reporting, Compliance und operative Prozesse aufgebaut.
KI führt jedoch ein völlig anderes Nutzungsmuster ein.
Traditionelle Systeme speichern und übertragen Daten zwischen Anwendungen und Menschen. KI-Systeme interpretieren, kombinieren, bewerten, klassifizieren und generieren auf Basis dieser Daten kontinuierlich neue Ergebnisse.
Damit verändern sich die Anforderungen grundlegend.
In vielen Unternehmen orientieren sich Datenmodelle und Integrationen noch immer an den Strukturen der Quellsysteme – nicht an den Anforderungen konkreter KI-Anwendungsfälle.
Die Folgen:
- wichtige Kontextinformationen fehlen
- Beziehungen zwischen Entitäten sind nicht eindeutig modelliert
- Metadaten sind unvollständig
- Fachwissen existiert hauptsächlich in den Köpfen von Mitarbeitern
Diese Schwächen werden besonders sichtbar, wenn KI-Systeme semantische Konsistenz benötigen.
Beispielsweise benötigen:
- Empfehlungssysteme ein stabiles Verhaltensmodell
- Copilots nachvollziehbare Quellen
- Prognosemodelle konsistente historische Signale
- Retrieval-Systeme aussagekräftige Metadaten
Daten können technisch korrekt sein und dennoch für KI unbrauchbar bleiben.
Der Grund: Der Kontext, der für die Interpretation notwendig ist, wurde nie explizit modelliert.
Viele Unternehmen reagieren darauf mit noch mehr Datensammlung.
In der Praxis verschärft dies das Problem häufig:
- irrelevante Attribute erhöhen das Rauschen
- schwache Metadaten verschlechtern die Auffindbarkeit
- unklare Beziehungen erzeugen Mehrdeutigkeit
KI profitiert nicht von möglichst vielen Daten.
Sie profitiert von Daten mit klarer Bedeutung, nachvollziehbarer Herkunft und eindeutigem Kontext.
Unstrukturierte Daten offenbaren die größte Readiness-Lücke
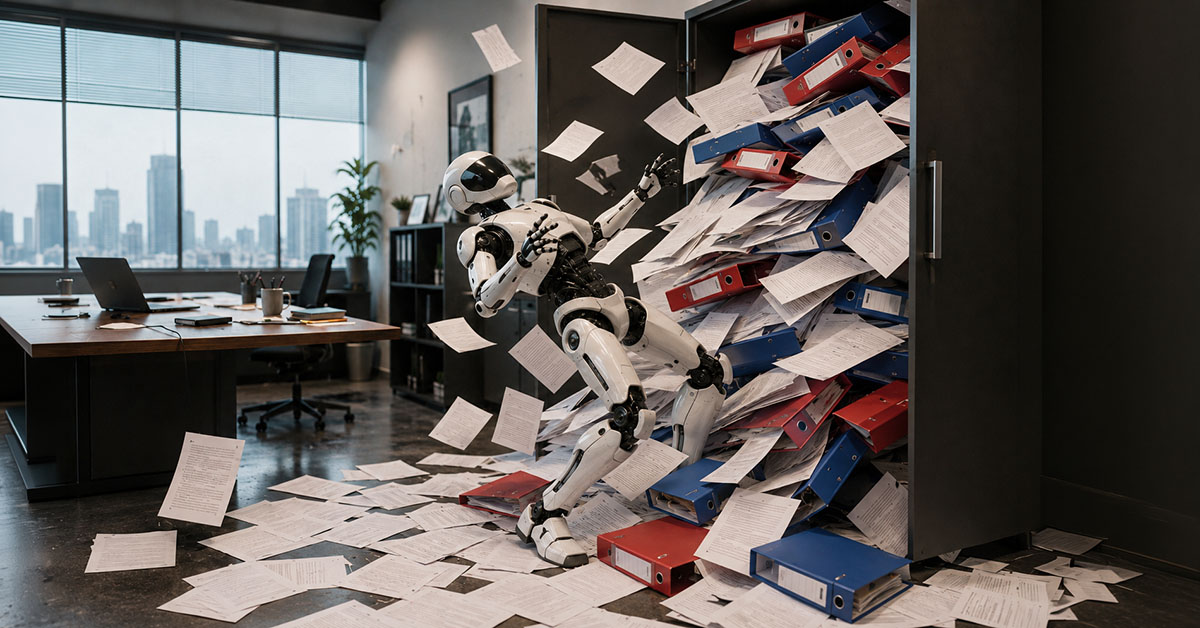
Für viele Unternehmen befinden sich die wertvollsten Informationen für KI-Anwendungen nicht in Datenbanken.
Sie liegen in:
- technischen Dokumentationen
- Verträgen
- Serviceberichten
- Produktspezifikationen
- E-Mails
- Wissensdatenbanken
- Support-Tickets
- PDF-Dokumenten
- Betriebsanweisungen
Genau dort steckt häufig das Wissen, das KI-Systeme benötigen:
- Produktverhalten
- betriebliche Abläufe
- Kundenanforderungen
- technische Einschränkungen
- historische Entscheidungen
Trotz ihres Werts werden diese Inhalte oft nur unzureichend verwaltet.
Typische Probleme sind:
- uneinheitliche Klassifizierung
- fehlende Verantwortlichkeiten
- unvollständige Metadaten
- veraltete Dokumentversionen
- redundante Inhalte
- unklare Zugriffsrechte
Besonders deutlich wird dies bei Enterprise Copilots und Retrieval-Augmented-Generation-(RAG)-Systemen.
Hier führen schlecht gepflegte Wissensbestände häufig zu:
- widersprüchlichen Antworten
- veralteten Empfehlungen
- unvollständigen Zusammenfassungen
- Antworten aus wenig vertrauenswürdigen Quellen
Viele Unternehmen sprechen in solchen Fällen von Halluzinationen.
Bei genauerer Betrachtung liegt das Problem jedoch häufig nicht beim Modell, sondern in den zugrunde liegenden Inhalten.
Die Qualität von Enterprise-KI wird zunehmend bestimmt durch:
- Retrieval-Qualität
- Quellennachvollziehbarkeit
- Dokumentenstrukturen
- Metadatenkonsistenz
- Content Governance
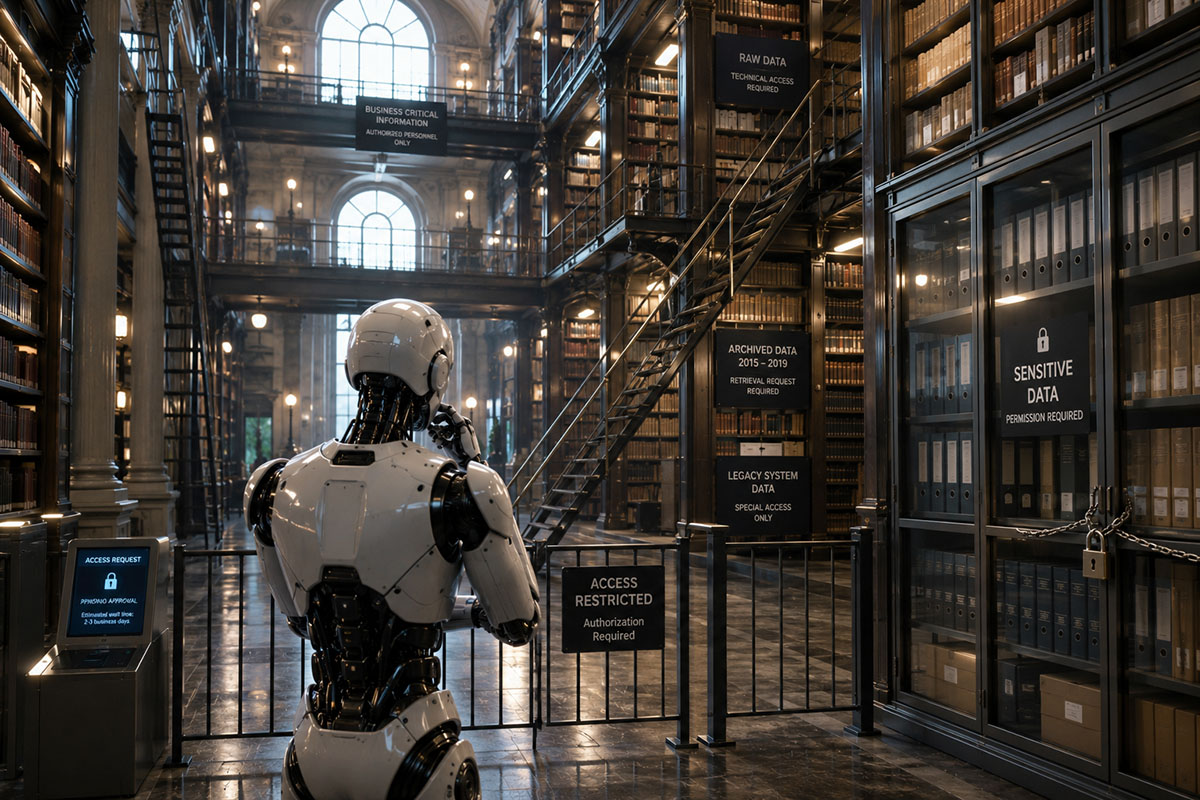
Datenzugriff bleibt ein operativer Engpass
Viele Unternehmen betrachten ihre Daten als zugänglich, weil sie zentral gespeichert oder technisch integriert sind.
Die operative Realität sieht häufig anders aus.
Der Zugriff auf relevante Daten erfordert oft noch:
- Freigabeprozesse
- Tickets
- manuelle Exporte
- individuelle Transformationen
- Unterstützung durch technische Teams
Hinzu kommt, dass Dokumentationen häufig lückenhaft oder veraltet sind.
Besonders betroffen sind Informationen zu:
- Datenherkunft
- Fachdefinitionen
- Transformationsregeln
- historischen Änderungen
Mit zunehmender Verbreitung von KI entstehen daraus erhebliche Engpässe.
Die Reaktion ist vorhersehbar:
- lokale Datenkopien entstehen
- Schattenprozesse werden aufgebaut
- Fachbereiche entwickeln eigene Lösungen
- isolierte KI-Initiativen entstehen außerhalb zentraler Governance
Im Ergebnis existieren mehrere Versionen derselben Realität.
Jede speist eigene KI-Anwendungen mit unterschiedlichen Annahmen, Regeln und Interpretationen.
Unter diesen Bedingungen leidet die Reproduzierbarkeit.
Dieselbe Anfrage kann unterschiedliche Ergebnisse liefern – abhängig davon, auf welche Datenbasis ein System zugreift.
Fehlende Ownership entlang des Datenlebenszyklus
Viele Unternehmen betrachten Daten noch immer primär als Nebenprodukt von Anwendungen und Prozessen.
Entsprechend verteilt sich die Verantwortung:
- Applikationsteams betreiben Systeme
- Plattformteams betreiben Infrastruktur
- Analytics-Teams erstellen Berichte
- Governance-Teams definieren Richtlinien
Wer jedoch langfristig für die Nutzbarkeit der Daten verantwortlich ist, bleibt häufig unklar.
Für KI-Initiativen entsteht daraus ein erhebliches Risiko.
Typische Folgen sind:
- unterschiedliche Definitionen in verschiedenen Bereichen
- lokale Sonderlösungen
- isolierte Transformationslogiken
- Wissen, das an einzelne Personen gebunden bleibt
KI-Systeme verstärken diese Schwächen.
Sie benötigen stabile Semantik und konsistente Interpretation über alle Bereiche hinweg.
Fehlt eine klare Verantwortung:
- verschlechtern sich Metadaten
- wird Datenherkunft schwer nachvollziehbar
- sinkt die Qualität von Retrieval-Prozessen
- werden KI-Ergebnisse schwieriger erklärbar
Viele Unternehmen erkennen diese Governance-Lücken erst dann, wenn KI-Initiativen skaliert werden.
Zu diesem Zeitpunkt ist die Komplexität meist bereits deutlich gestiegen.
Fazit
Viele Unternehmen bewerten heute ihre KI-Reife – tatsächlich bewerten sie jedoch vor allem ihre Infrastruktur, ihre Plattformen oder ihre Analytics-Fähigkeiten.
Data Readiness für KI ist etwas anderes.
KI-Systeme führen ein neues Betriebsmodell für Unternehmensdaten ein:
- direkte maschinelle Nutzung
- kontinuierliche Interpretation
- automatisierte Informationsbeschaffung
- semantische Abhängigkeiten
- geringe Toleranz gegenüber Mehrdeutigkeit
Unter diesen Bedingungen werden langjährige Schwächen sichtbar.
Fragmentierte Daten, unzureichende Qualität, schlecht verwaltete Inhalte, eingeschränkter Datenzugriff und fehlende Verantwortlichkeiten wirken sich unmittelbar auf die Qualität von KI-Ergebnissen aus.
Unternehmen, die KI erfolgreich im großen Maßstab einsetzen, behandeln Daten deshalb anders:
Nicht als gespeicherte Information, sondern als kontinuierlich gepflegtes Betriebsvermögen – mit klaren Verantwortlichkeiten, konsistenter Semantik, nachvollziehbarer Herkunft und einer Struktur, die für die Nutzung durch Maschinen entwickelt wurde.
Die entscheidende Frage lautet daher nicht:
Wie KI-fähig ist unsere Technologie?
Sondern:
Wie KI-fähig sind unsere Daten?
Der nächste Schritt besteht darin, zu verstehen, wie eine solche Umgebung in der Praxis tatsächlich aussieht.
Darauf werden wir in Teil 2 eingehen.
Das könnte Ihnen auch gefallen:
- KI im E-Commerce (E-Book) » Mehr erfahren
- Was Googles Universal Commerce Protocol für die Zukunft des B2B-Commerce bedeutet » Mehr erfahren
- Agentic Commerce: Strategische Prioritäten für Führungskräfte » Mehr erfahren
- Agentic Commerce: Das neue Machtgefüge im digitalen Handel » Mehr erfahren
- Agentic Commerce: So werden Gespräche zu Käufen » Mehr erfahren
- Generative KI erschließt das Potenzial unstrukturierter Daten in der Versicherungswirtschaft » Mehr erfahren